
Écrits · 1 déc. 2019
Reconnaissance de la posture humaine en temps réel grâce à la vision par ordinateur
TensorFlow et PoseNet sur un flux vidéo
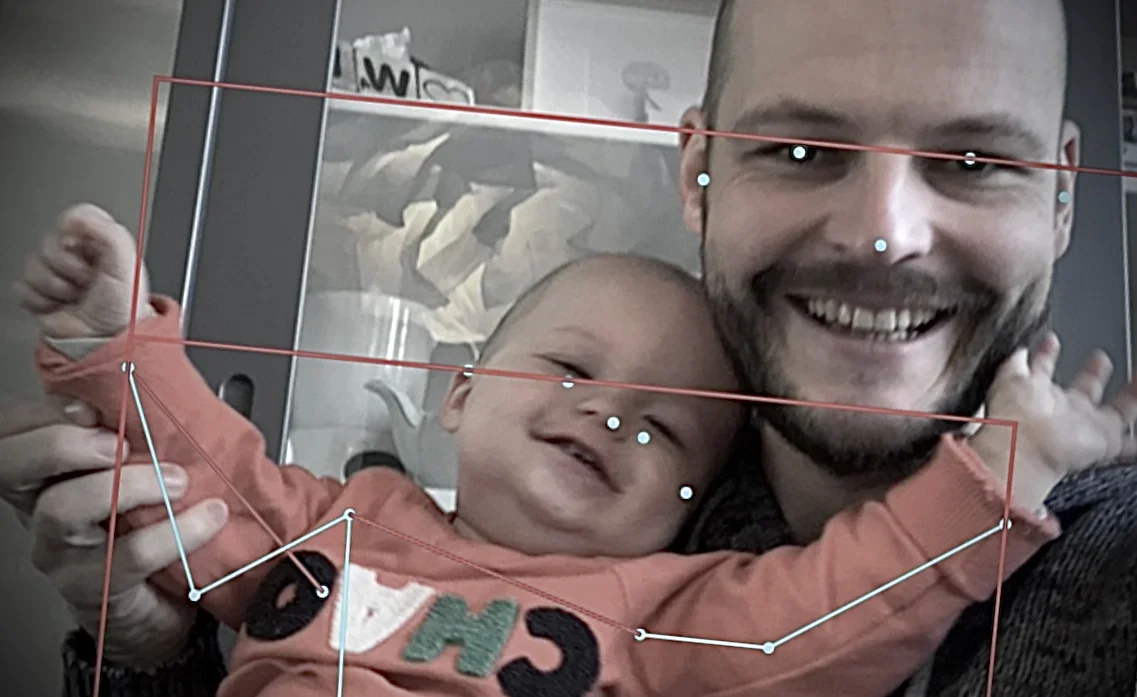
Pour un nouveau projet passionnant, j'ai expérimenté la vision par ordinateur avec TensorFlow. Je voulais obtenir une détection de la posture humaine en temps réel, pour piloter des projections vidéo interactives et des jeux. Il était temps de plonger dans le monde de l'apprentissage automatique, des tenseurs et de la vision par ordinateur !
La vision par ordinateur
Le domaine scientifique interdisciplinaire de la vision par ordinateur est vraiment passionnant : il étudie comment des ordinateurs peuvent acquérir une compréhension de haut niveau à partir d'images numériques et de flux vidéo. Cela comprend les défis liés à l'acquisition, au traitement et à l'analyse d'images numériques. À terme, tu veux que l'ordinateur prenne des décisions sur la base de sa compréhension du monde (complexe) qui l'entoure.
TensorFlow
TensorFlow est une plateforme open source de bout en bout pour l'apprentissage automatique, développée à l'origine par Google. Elle s'appuie sur les travaux scientifiques de nombreux chercheurs et est devenue depuis un écosystème stable et robuste d'outils, de bibliothèques et de ressources communautaires.
Le nom « TensorFlow » vient de l'idée d'un « flux de tenseurs ». Un tenseur se décrit le mieux comme une « chose », par exemple quelque chose que l'ordinateur a reconnu, ou qu'il essaie d'analyser. Techniquement, un tenseur est un tableau multidimensionnel de valeurs numériques. Cela permet à l'ordinateur de comparer différentes « choses » et de voir en quoi leurs caractéristiques se ressemblent (ou diffèrent).
Le grand défi du traitement d'image en temps réel, c'est de réduire la complexité de l'image à des morceaux exploitables, exprimables sous forme de tenseurs. En général, l'algorithme de vision par ordinateur passe par de nombreuses étapes : reconnaître une forme, recadrer sur cette forme, la redimensionner, retirer sa couleur, comparer les contours, etc. Les tenseurs circulent à travers ces étapes, de « non analysé » à « reconnu », d'où le nom TensorFlow.
Puissance de calcul
Ce qui est génial avec l'apprentissage automatique moderne sous TensorFlow, c'est qu'il ne faut généralement pas de matériel (très) coûteux pour obtenir des résultats. Le « gros du travail » se fait en effet pendant l'entraînement des modèles, que tu peux imaginer un peu comme des « tables de référence ». Ces modèles sont créés en analysant des jeux de données connus, où l'ordinateur reçoit la « réponse » et en déduit les caractéristiques du sujet. Entraîner des modèles demande du temps, de la puissance de calcul et des données d'entraînement.
Données d'entraînement
Google a fait quelque chose de vraiment malin : l'entraînement de ses modèles d'apprentissage automatique, il l'a distribué à nous tous. Oui, toi aussi !
reCAPTCHA
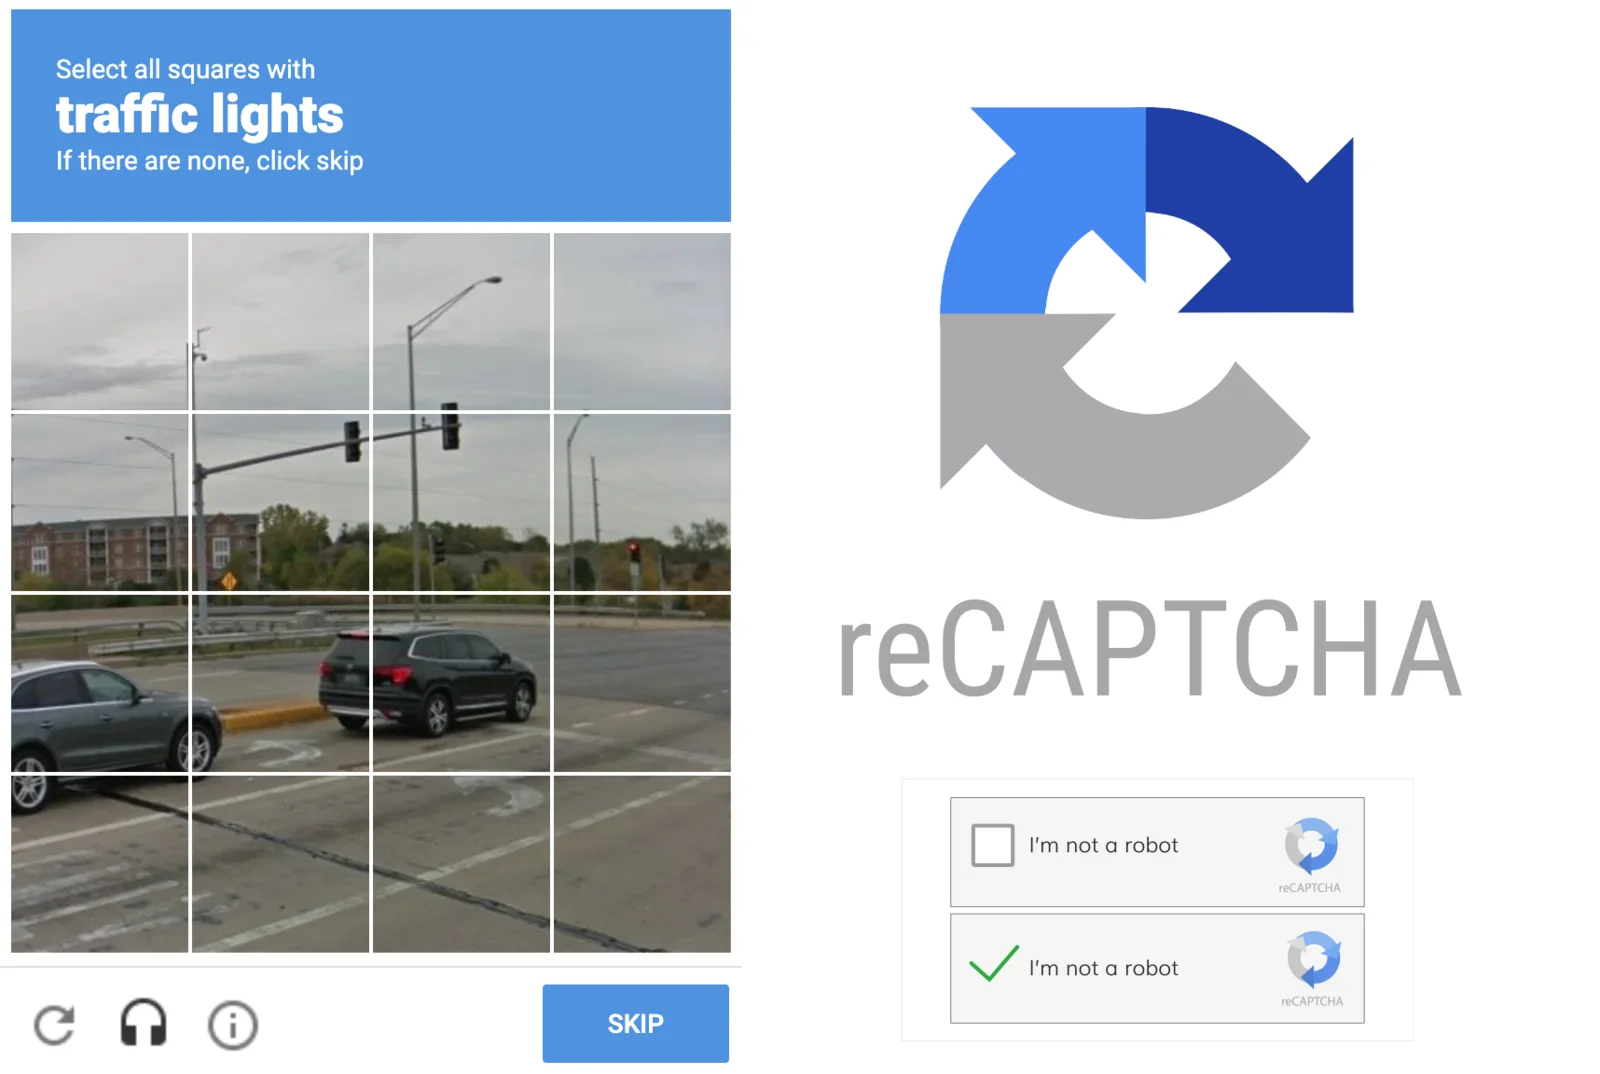
Il y a de fortes chances que tu aies déjà croisé « reCAPTCHA » ou « captcha ». C'est ce test visuel à passer quand tu commandes quelque chose en ligne ou que tu t'inscris quelque part. Il protège les propriétaires de boutiques et de sites web contre les (spam)bots. Son but est de distinguer les humains des robots. Pour cela, il montre aux humains des images (complexes) en leur demandant d'y identifier des objets : panneaux de signalisation, passages piétons, voitures, etc. Google utilise ces réponses humaines pour entraîner ses modèles.
Le plus beau, c'est que beaucoup des découvertes de Google sont rendues publiques. Il existe plein de projets open source intéressants qui nous permettent, à nous, simples développeurs, de faire des choses incroyables avec l'apprentissage automatique.
Reconnaître la posture humaine avec PoseNet
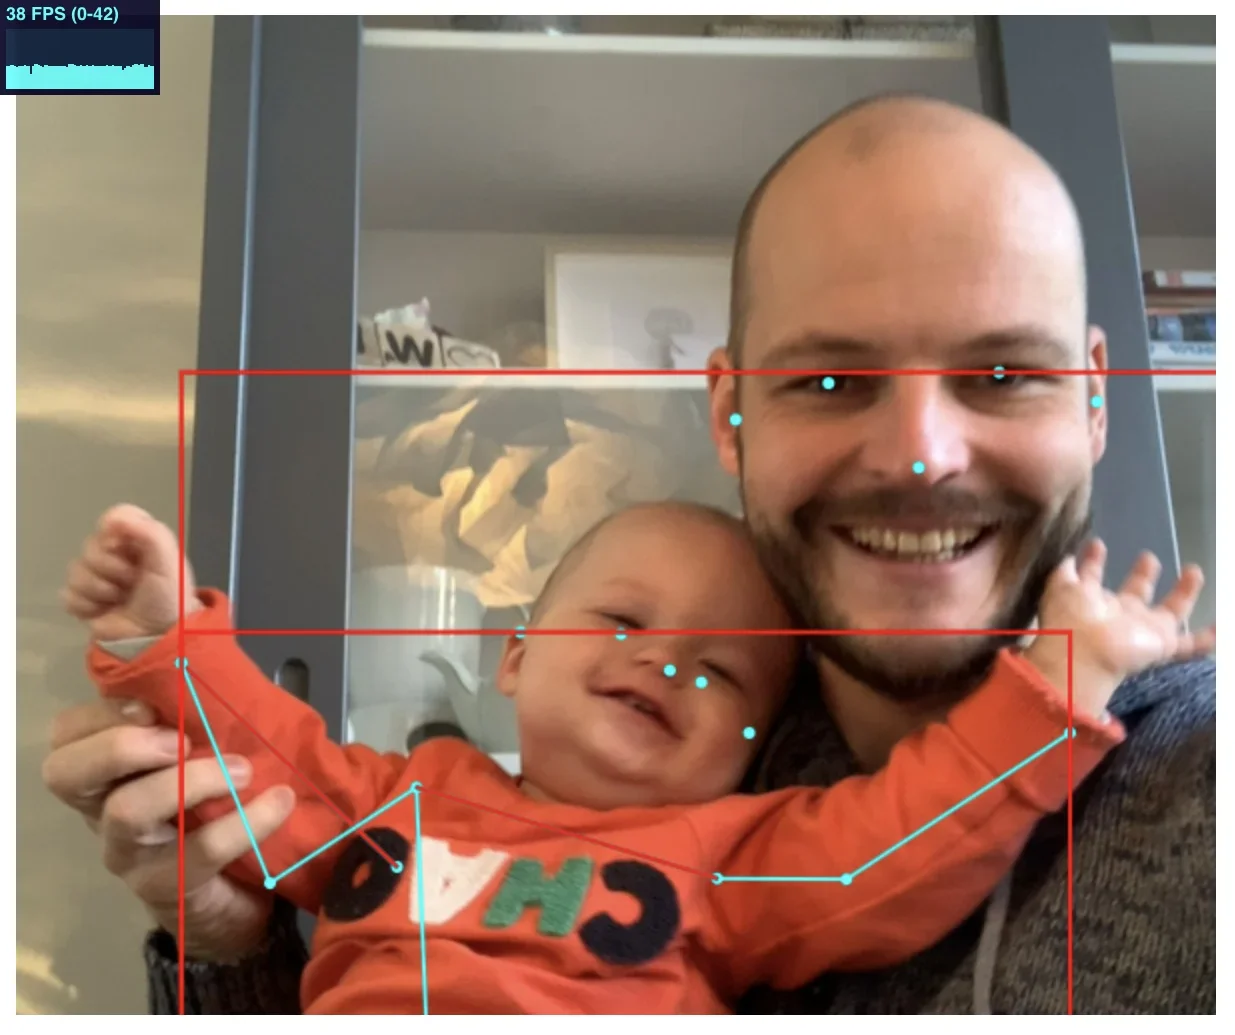
PoseNet est l'un de ces modèles d'apprentissage automatique disponibles. C'est un modèle de vision qui permet d'estimer la posture d'une personne dans une image ou une vidéo. Pour cela, il détermine où se trouvent les principales articulations du corps : coudes, mains, hanches, genoux, chevilles, etc.
L'algorithme Single Shot MultiBox Detector (SSD)
Le Single Shot MultiBox Detector est un algorithme très répandu pour détecter des objets dans des images et des flux vidéo. Il doit sa popularité à sa vitesse. Le principe est relativement simple à comprendre : l'algorithme essaie de réduire la complexité de l'image le plus vite possible, et ne fait d'analyses poussées que sur des cartes de caractéristiques réduites et simplifiées.
Cette approche fonctionne mieux pour détecter de grands objets, qui ressortent vite : ils produisent assez tôt dans l'algorithme assez de caractéristiques de haut niveau pour faire des prédictions. C'est idéal pour détecter un corps, l'une des premières étapes quand on veut déterminer des postures humaines (d'abord regarder où se trouve une personne, puis quelle est sa posture).
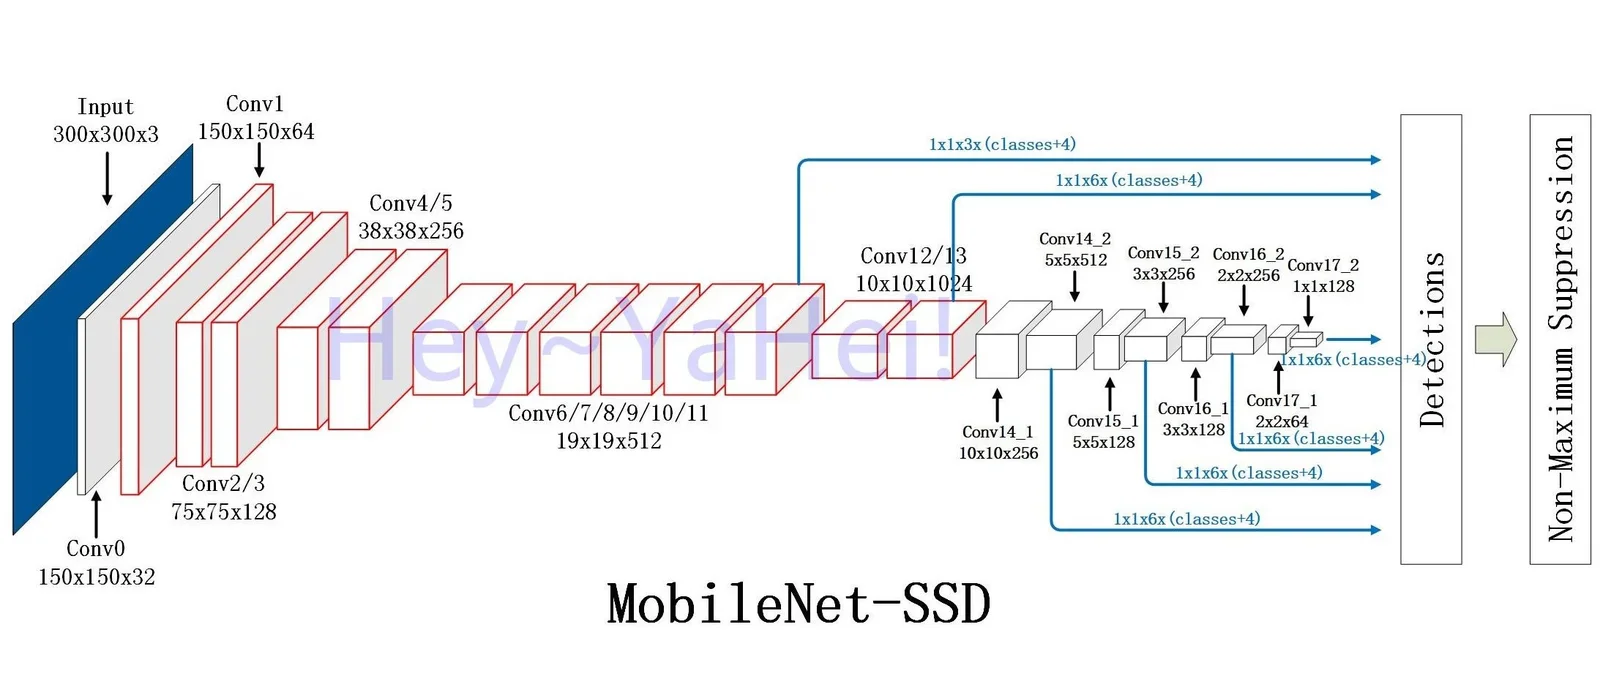
La reconnaissance d'images et de personnes, c'est un domaine où les Chinois sont plutôt forts, pour diverses raisons. Leurs algorithmes tournent bien sur du matériel relativement modeste. Résultat : la vision par ordinateur fonctionne bien sur toutes sortes d'appareils, en temps réel !
Des cas d'usage sympas
Pouvoir détecter des postures en temps réel ouvre la porte à plein de choses sympas. Tu peux, au sens propre, devenir la manette de jeu ou l'interface d'une installation d'art interactive !
Le miroir PomPom
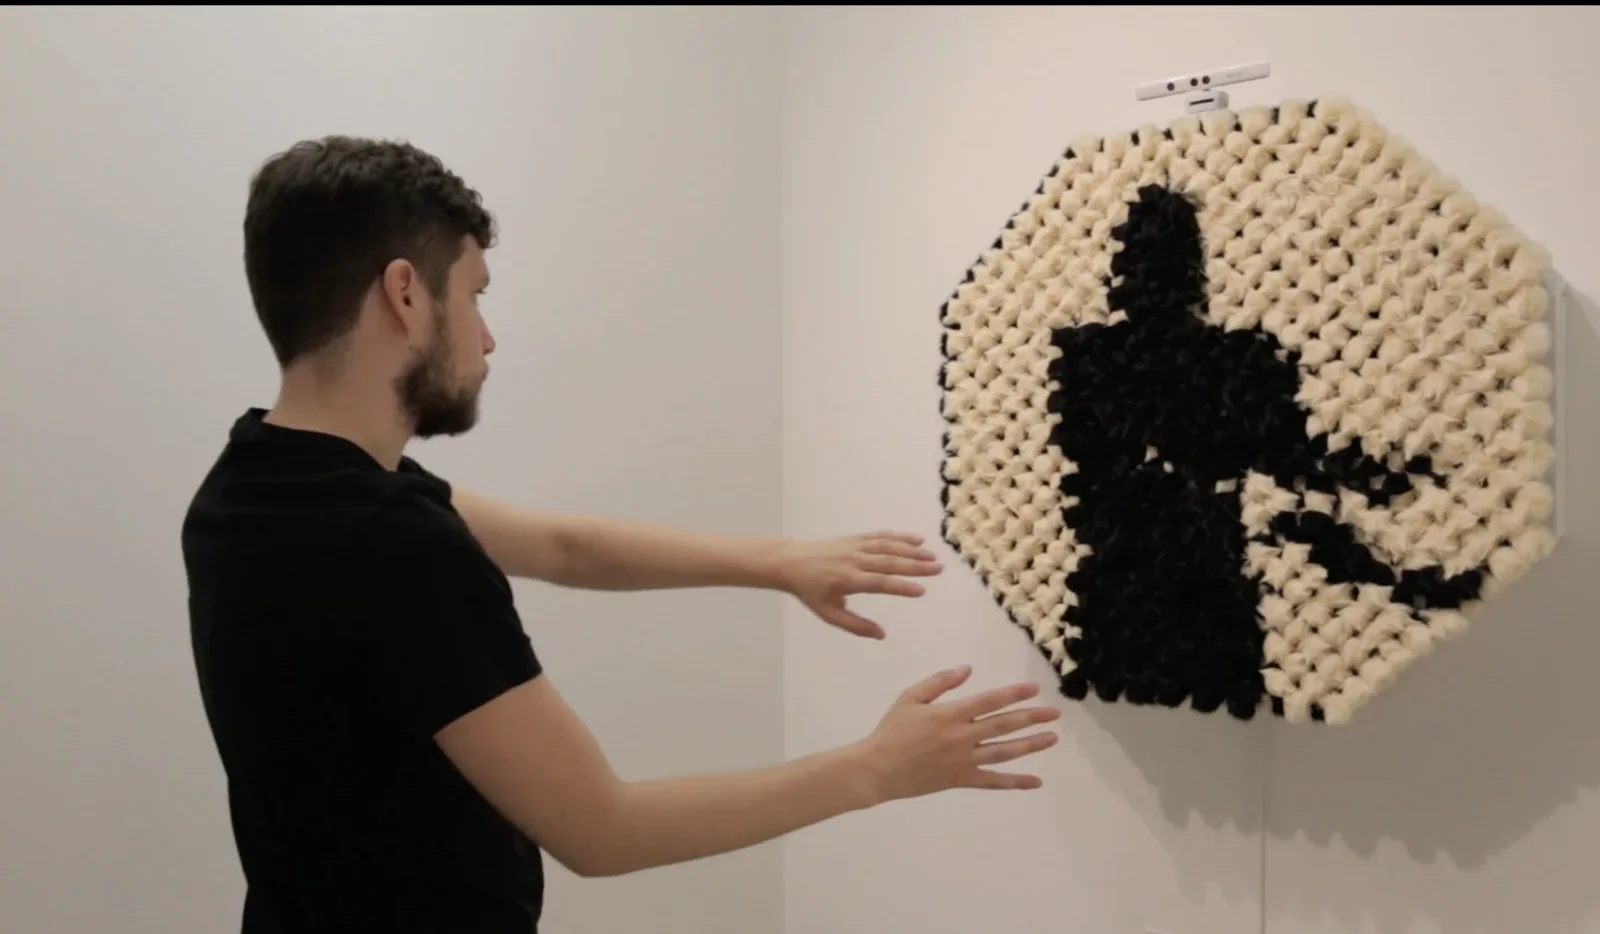
Avec ses 928 pompons sphériques en fausse fourrure, cette installation artistique de Daniel Rozin est incroyable. La sculpture est pilotée par des centaines de moteurs qui dessinent la silhouette des spectateurs grâce à la vision par ordinateur.
Se transformer en oiseau : The Treachery of Sanctuary
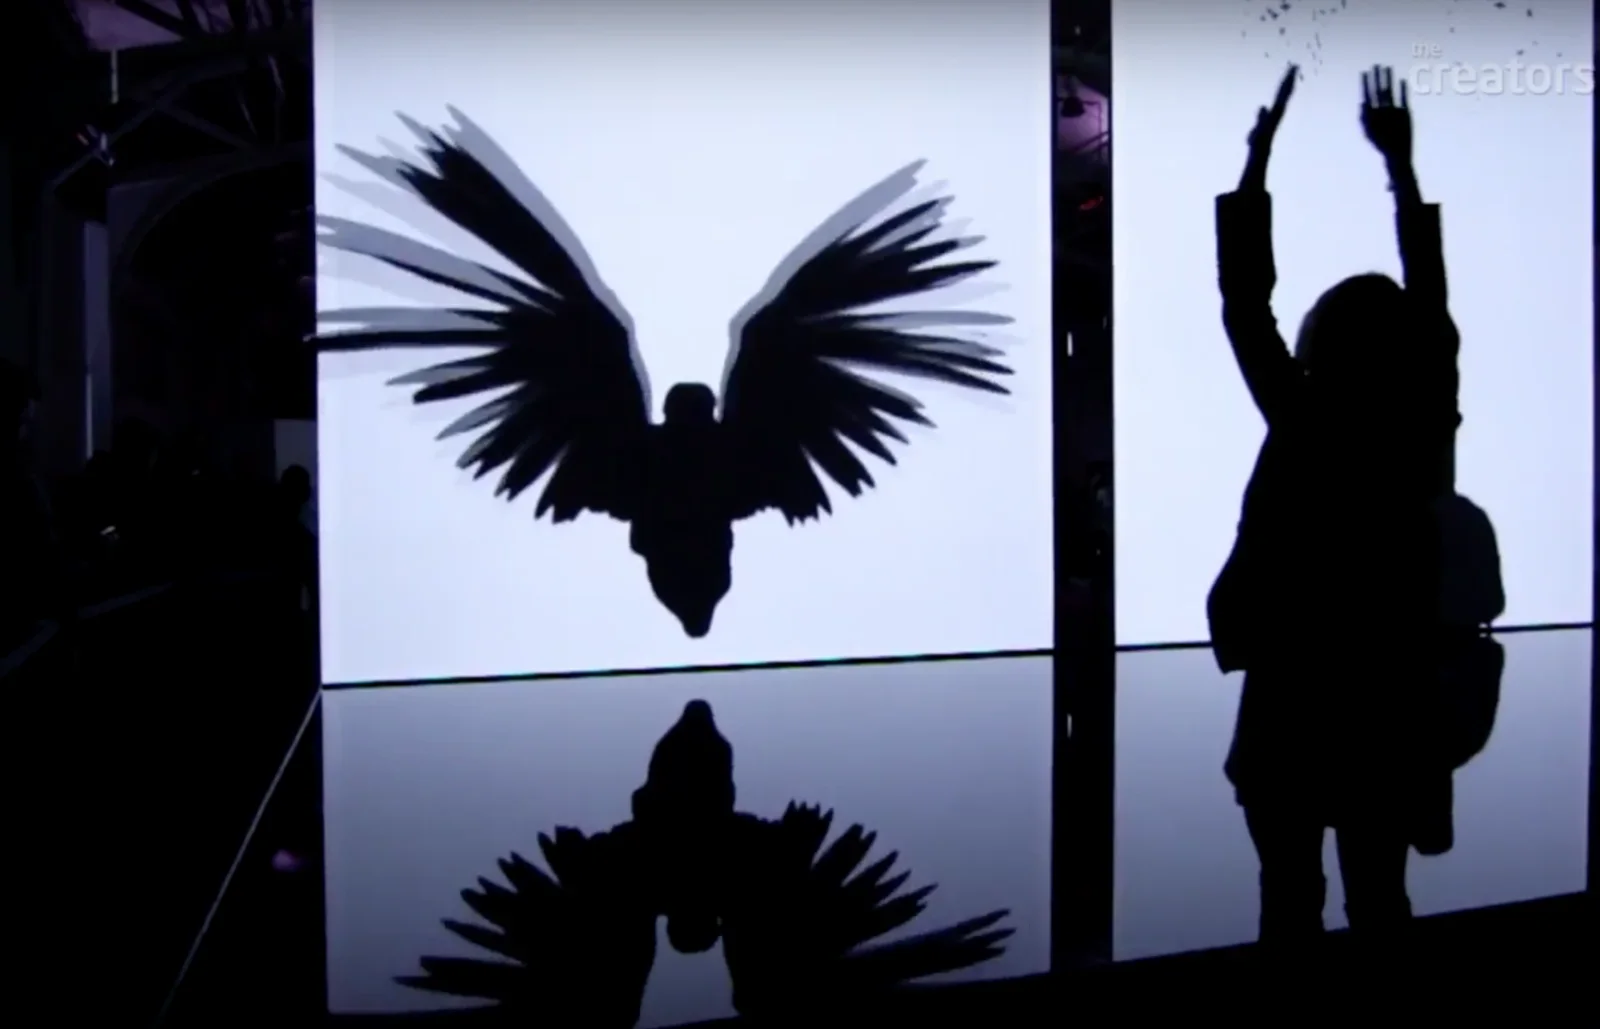
Faire en sorte que les gens se perdent un instant n'a été possible qu'en réunissant des disciplines différentes. Cette incroyable installation d'art interactive réalisée par Chris Milk est un immense triptyque qui, grâce à la vision par ordinateur, fait traverser aux spectateurs différentes étapes du vol.
Conclusion
Travailler sur des projets créatifs et expérimentaux est un privilège incroyable, c'est ce qui rend mon travail si passionnant.
Avec des montagnes de données toujours plus grandes, donner du sens de manière numérique et autonome sera un défi majeur pour l'avenir : un défi sur lequel j'ai très envie de travailler !