
Scrittura · 1 dic 2019
Riconoscimento della posa umana in tempo reale con la computer vision
Usare TensorFlow e PoseNet su un flusso video
Per un nuovo progetto entusiasmante ho sperimentato la computer vision con TensorFlow. Volevo ottenere il riconoscimento della posa umana in tempo reale, per pilotare proiezioni video interattive e giochi. Era ora di tuffarsi nel mondo del machine learning, dei tensori e della computer vision!
Computer vision
È davvero affascinante il campo scientifico interdisciplinare della computer vision, che studia come far acquisire ai computer una comprensione di alto livello a partire da immagini digitali e flussi video. Comprende le sfide di acquisire, elaborare e analizzare immagini digitali. Alla fine vuoi che il computer prenda decisioni in base a ciò che capisce del (complesso) mondo che lo circonda.
TensorFlow
TensorFlow è una piattaforma open source end-to-end per il machine learning, sviluppata in origine da Google. Si basa sul lavoro scientifico di vari studiosi ed è diventata nel tempo un ecosistema stabile e robusto di strumenti, librerie e risorse della community.
Il nome "TensorFlow" deriva dal concetto di "flusso di tensori". Un tensore si descrive meglio come una "cosa", per esempio qualcosa che il computer ha riconosciuto, o che cerca di analizzare. Tecnicamente un tensore è un array multidimensionale di valori numerici. Così il computer può confrontare "cose" diverse e vedere quanto le loro caratteristiche si somigliano (o differiscono).
La sfida principale nell'elaborazione di immagini in tempo reale è ridurre la complessità dell'immagine in pezzi gestibili, che si possano esprimere come tensori. Di solito l'algoritmo di computer vision si compone di molti passaggi. Passaggi come riconoscere una forma, ritagliare proprio quella forma, ridimensionarla, toglierle il colore, confrontare i contorni, eccetera. I tensori scorrono attraverso questi passaggi, da "non analizzato" a "riconosciuto", da cui il nome TensorFlow.
Potenza di calcolo
Il bello del machine learning moderno con TensorFlow è che in genere non servono hardware (molto) costosi per ottenere risultati. Il motivo è che il "lavoro pesante" si fa quando si addestrano i modelli di machine learning, che puoi immaginare un po' come "tabelle di riferimento". Questi modelli nascono analizzando dataset noti, in cui il computer riceve la "risposta" e ricava le caratteristiche del soggetto. Addestrare i modelli richiede tempo, potenza di calcolo e dati di addestramento.
Dati di addestramento
Google ha fatto una cosa davvero geniale: ha distribuito l'addestramento dei suoi modelli di machine learning a tutti noi. Sì, compreso te!
reCAPTCHA
Può darsi che ti sia già imbattuto in un "reCAPTCHA". È quella prova visiva da superare quando ordini qualcosa online o provi a registrarti da qualche parte. Protegge i proprietari di negozi e siti web dagli (spam)bot e serve a distinguere gli umani dai bot. Lo fa mostrando agli umani immagini (complesse) e chiedendo di identificare gli oggetti al loro interno. Come segnali stradali, incroci, auto, eccetera. Google usa questo feedback umano per addestrare i suoi modelli.
Il bello è che molte scoperte di Google sono rese pubbliche, e ci sono tanti progetti open source interessanti che permettono a noi, semplici sviluppatori, di fare cose incredibili con il machine learning.
Riconoscimento della posa umana con PoseNet
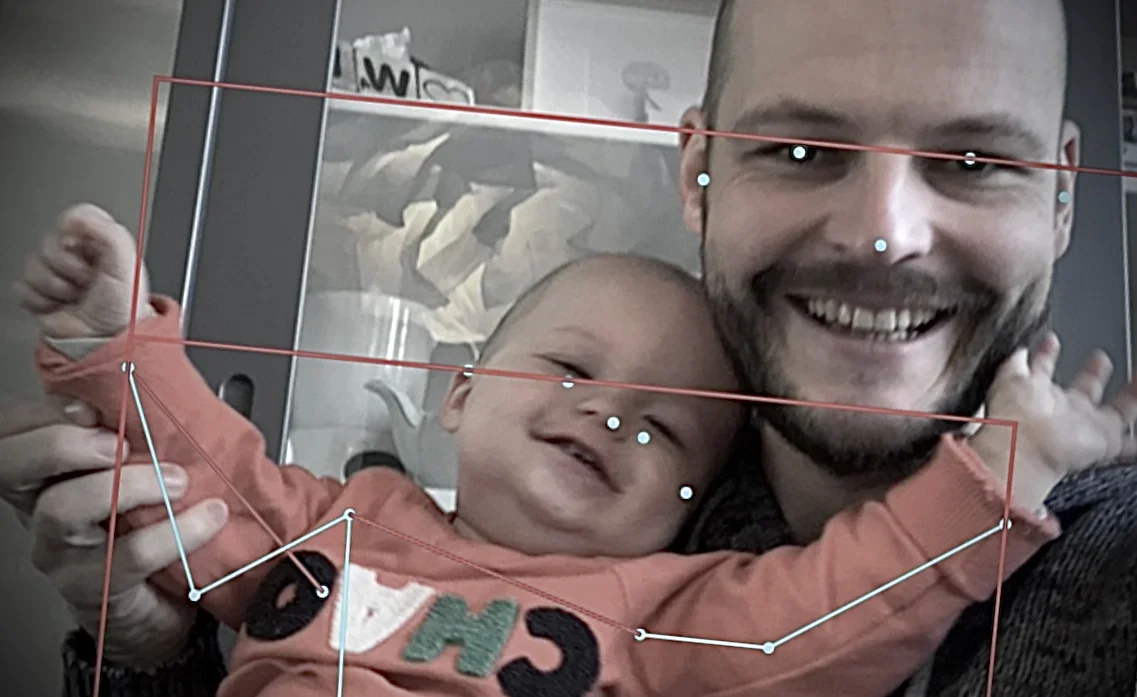
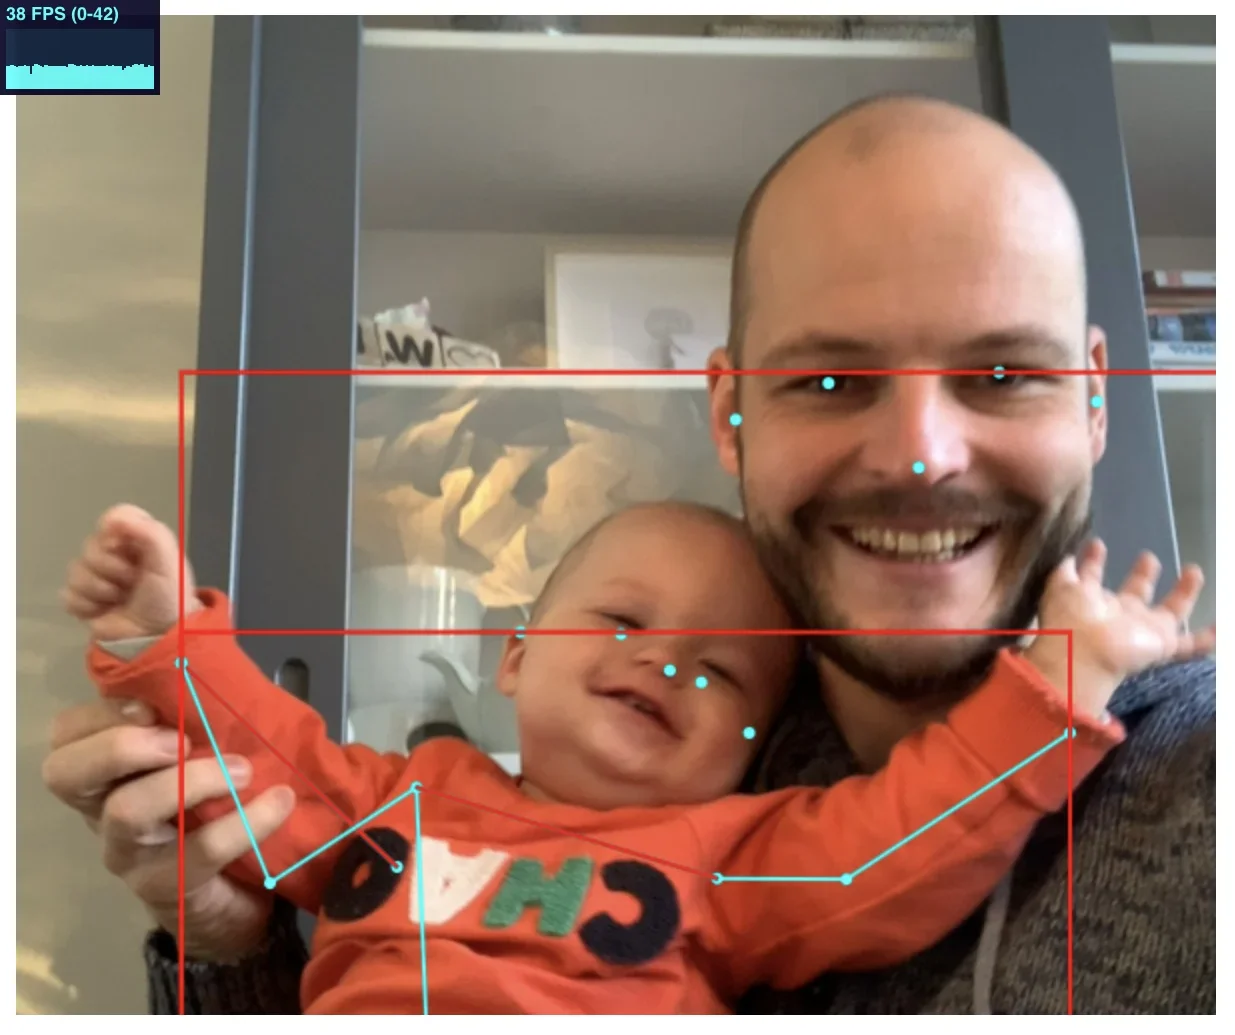
Uno dei modelli di machine learning disponibili è PoseNet. È un modello di visione che permette di stimare la posa di una persona in un'immagine o in un video. Lo fa determinando dove si trovano le articolazioni principali del corpo, come gomiti, mani, fianchi, ginocchia, caviglie, eccetera.
L'algoritmo Single Shot MultiBox Detector (SSD)
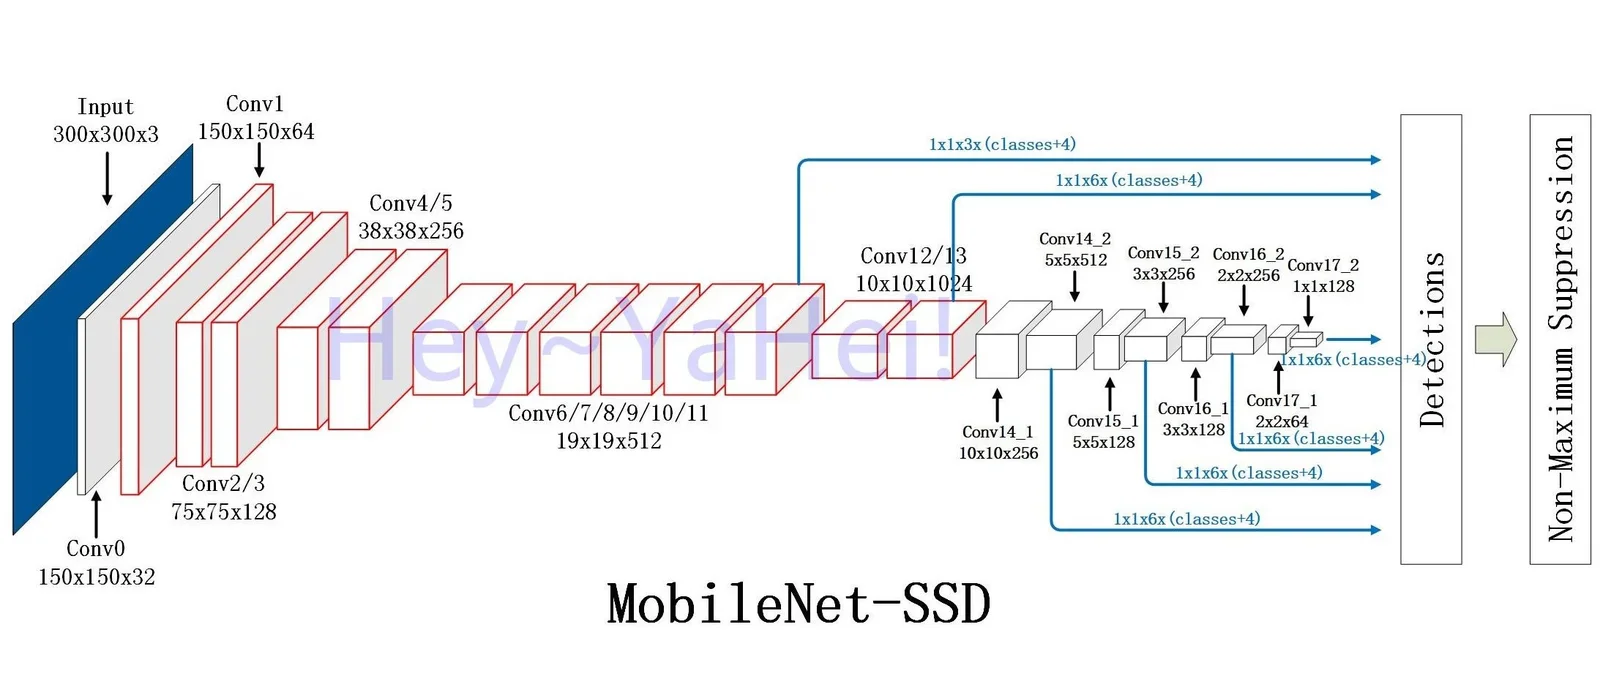
Il Single Shot MultiBox Detector è un algoritmo molto diffuso per rilevare oggetti in immagini e flussi video. È popolare per la sua velocità. Il principio è relativamente semplice da capire: l'algoritmo cerca di ridurre la complessità dell'immagine il più in fretta possibile, facendo analisi approfondite solo su mappe di caratteristiche rimpicciolite e semplificate.
Questo approccio funziona meglio se vuoi rilevare oggetti grandi, perché si fanno notare subito: producono abbastanza caratteristiche di alto livello da permettere previsioni già nelle prime fasi dell'algoritmo. Ottimo per il rilevamento del corpo, che è uno dei primi passi quando vuoi determinare le pose umane (prima guardi dove si trova una persona, poi qual è la sua posa).
Nel riconoscimento di immagini e persone i cinesi sono piuttosto bravi, per vari motivi. I loro algoritmi funzionano bene su hardware relativamente debole. Così la computer vision gira bene su ogni genere di dispositivo, in tempo reale!
Casi d'uso fighissimi
Poter rilevare le pose in tempo reale apre la strada a un sacco di cose divertenti. Puoi diventare, letteralmente, il controller di un gioco o l'input di un'installazione artistica interattiva!
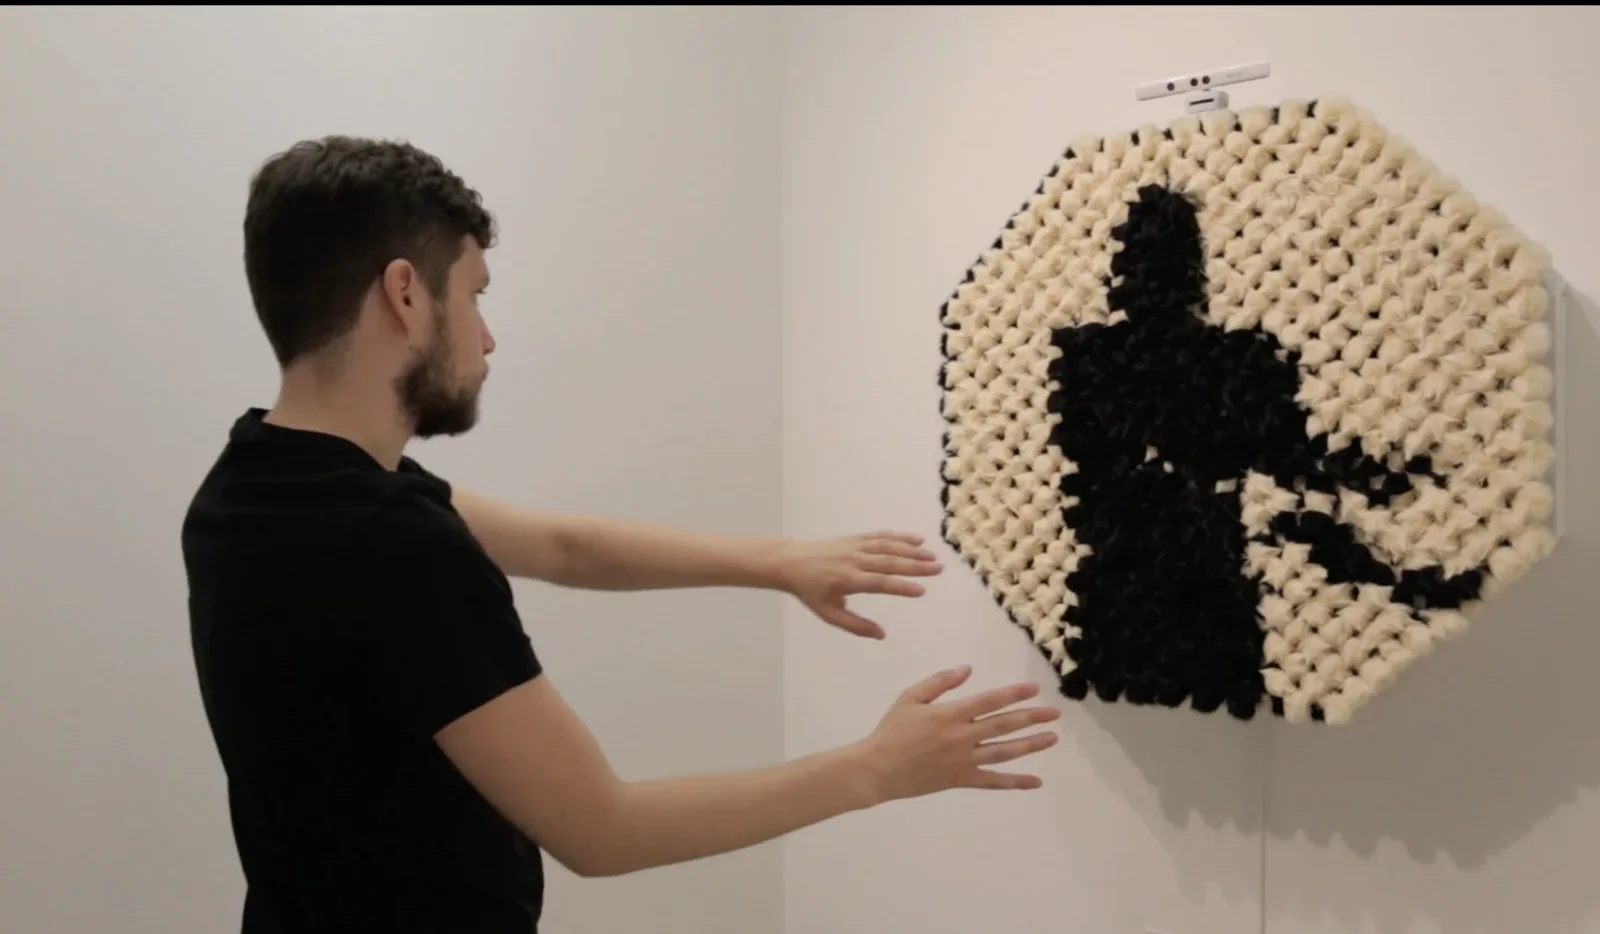
Lo specchio PomPom
Con i suoi 928 pompon sferici di finta pelliccia, questa installazione artistica di Daniel Rozin è fantastica. La scultura è comandata da centinaia di motori che costruiscono le sagome degli spettatori usando la computer vision.
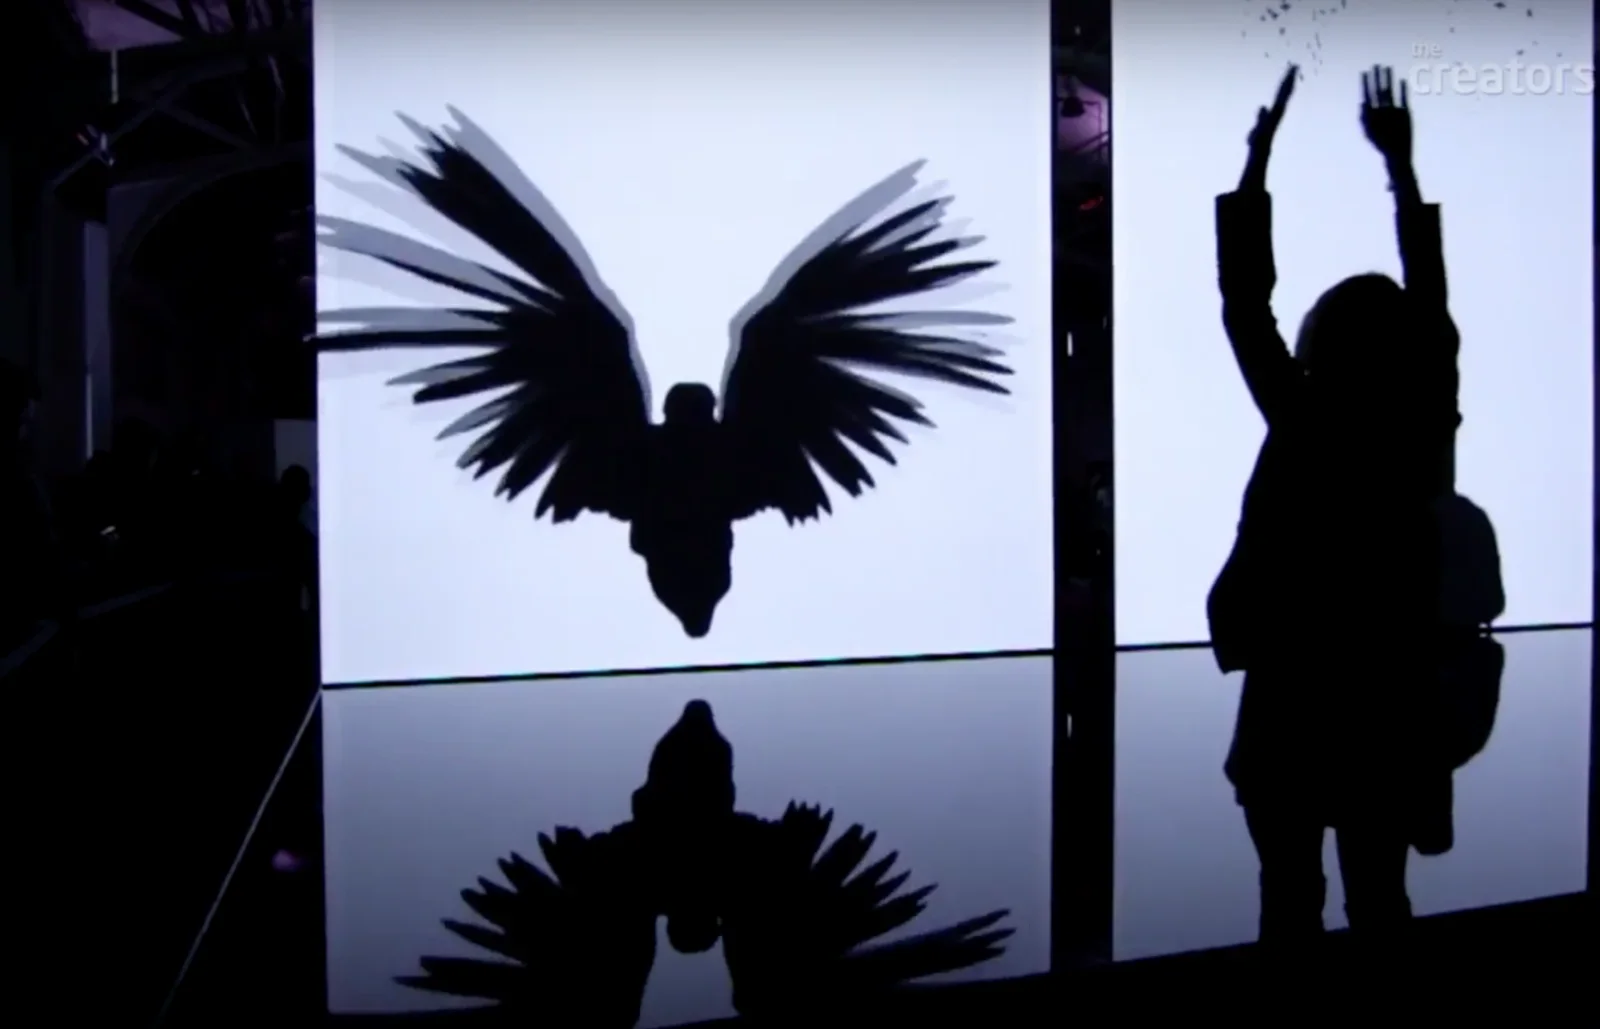
Trasformarti in un uccello: The Treachery of Sanctuary
Permettere alle persone di perdersi per un momento è stato possibile solo unendo discipline diverse. Questa fantastica installazione artistica interattiva diretta da Chris Milk è un gigantesco trittico che, grazie alla computer vision, accompagna gli spettatori attraverso le varie fasi del volo.
Conclusione
Lavorare a progetti creativi e sperimentali è un privilegio incredibile, ed è ciò che rende il mio lavoro così entusiasmante.
Con quantità di dati sempre più enormi, dare un senso digitale e autonomo a tutto questo è una grande sfida per il futuro: una sfida su cui voglio assolutamente lavorare!