
Scrittura · 2 dic 2020
Progettare una coda di capacità multidimensionale
Gestire la capacità di cucina, consegna e ritiro
Questo mese ho dovuto aggiungere nuove dimensioni a un meccanismo di coda di capacità. L’app per ordinare cibo che ho creato doveva poter limitare la capacità in base al numero di ordini, al contenuto dei singoli ordini e alla modalità di evasione (asporto/consegna). Leggi per scoprire come ho usato un’architettura Lambda per farlo.
Limitare la capacità
Anche se magari non te ne rendi conto, una delle funzioni più potenti dell’app per ordinare cibo che ho creato è proprio poter limitare il numero di ordini. Sembra controintuitivo, ma limitando il numero di ordini che si possono fare, i miei clienti (i ristoratori e i negozianti che usano la mia app) possono garantire che gli ordini vengano preparati e consegnati come si deve.
La complessità di tre pizze
Diciamo che vuoi ordinare tre pizze. L’app deve sapere:
- Vuoi ritirarle o farle consegnare?
- A che ora? quando devono andare in forno?
- C’è abbastanza spazio per tre pizze nel forno a quell’ora?
- Se hai scelto il ritiro: possiamo accoglierti in sicurezza a quell’ora?
- Se hai scelto la consegna: c’è un fattorino o una fattorina disponibile a portarti le pizze?
- Sì a tutto? Allora paga, per favore, mentre teniamo in programma le tue pizze nel forno e per la consegna o il ritiro. Pagamento non riuscito? Ripensamenti? Allora "annulliamo" tutta la pianificazione e aspettiamo che qualcun altro ordini delle pizze!
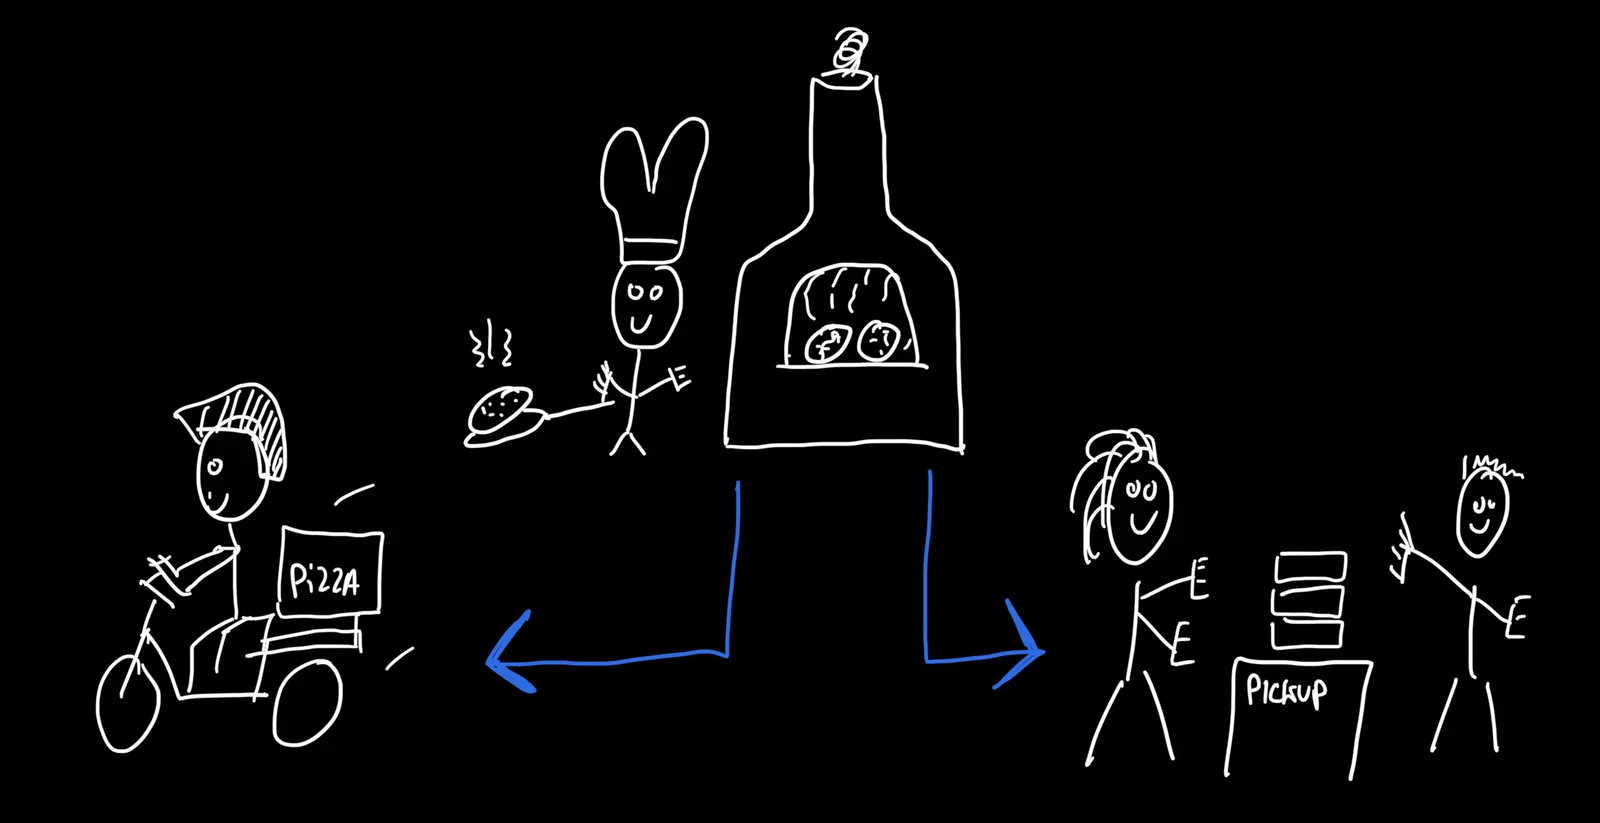
Tre dimensioni di capacità
Soprattutto intorno all’“ora di cena” c’è il rischio che troppe persone ordinino cibo contemporaneamente. L’app regge il traffico extra grazie alla sua architettura altamente scalabile, ma i limiti fisici restano, come:
- capacità della cucina: il numero di piatti che puoi preparare insieme
- capacità di ritiro: il numero di persone che puoi accogliere in sicurezza insieme, nel rispetto delle restrizioni COVID-19
- capacità di consegna: il numero di ordini che puoi consegnare, tenendo conto di traffico, distanza e percorso
Distinte ma interdipendenti
Questi tre tipi di vincoli sono interdipendenti. Per esempio, un grande ordine da ritirare può occupare tutta la capacità della cucina, rendendo indisponibile anche la consegna. Ordini più piccoli potrebbero comunque essere accettati per riempire la capacità della cucina, mentre per gli ordini grandi potrebbe non esserci più abbastanza capacità. Quindi serve un meccanismo che guardi tutte le metriche insieme per stabilire la disponibilità per i nuovi ordini, compreso il contenuto di un ordine non ancora effettuato (cioè cosa c’è nel carrello).
Differenze nella granularità dell’intervallo di tempo
Di solito un vincolo fisico si definisce con un intervallo di tempo, per esempio "la cucina può produrre 10 piatti ogni 15 minuti". Diventa difficile quando altri vincoli fisici sono definiti con intervalli di lunghezza diversa. La cucina può essere limitata per intervalli di 15 minuti, mentre la capacità di consegna può usare un intervallo più lungo (per esempio 3 consegne ogni 30 minuti). Il meccanismo deve in qualche modo gestire queste differenze di granularità.
Ordinare in anticipo
A complicare le cose c’è la possibilità di ordinare in anticipo. Le persone possono scegliere una fascia oraria futura e far riservare la capacità necessaria. A volte vedo persone ordinare con giorni di anticipo per essere sicure di ricevere il cibo in un giorno e a un’ora precisi. Quindi a ogni ordine sono associati (almeno) due orari: l’ora dell’ordine e l’ora della consegna.
Riservare e liberare capacità
La maggior parte dei titolari chiede il pagamento online per gli ordini online, per assicurarsi che tutti gli ordini siano veri e che non si sprechi capacità (o cibo) per clienti che non si presentano o ordini fantasma. Il problema dei pagamenti online è che non tutte le transazioni riescono. A volte un pagamento con carta di credito o di debito viene rifiutato (per esempio per fondi insufficienti). A volte le persone chiudono l’app prima di completare l’ordine. Il sistema deve riservare la capacità necessaria per un dato ordine mentre permette di fare il pagamento online, e deve liberare la capacità riservata se l’ordine viene abbandonato o il pagamento fallisce.
Grandi volumi, alta velocità
Infine, il meccanismo deve essere affidabile e performante. La disponibilità degli ordini va stabilita in pochi millisecondi gestendo una forte concorrenza, perché nell’ora di punta ci sono tanti client diversi collegati all’app. Quando qualcuno fa un ordine, influisce sulla disponibilità di tutti gli altri ordini (potenziali). Non tutti hanno una connessione stabile, perché alcuni usano l’app su telefoni con poca copertura o su Wi-Fi. Il sistema deve funzionare bene in condizioni variabili con tante persone collegate.
Architettura Lambda
L’architettura Lambda è un modo per gestire grandi quantità di dati usando sia l’elaborazione a flusso sia quella a lotti. Un’architettura lambda si basa su un modello di dati con una fonte di dati immutabile e in sola aggiunta, spesso composta da eventi con marca temporale.
Dati immutabili
È una base molto importante del meccanismo: tutti i dati hanno una marca temporale e non cambiano mai. Invece di modificare i record esistenti, se ne aggiungono semplicemente di nuovi che sovrascrivono quelli esistenti. Questo permette alta concorrenza e algoritmi distribuiti, perché la sincronizzazione diventa più semplice: basta cercare i dati nuovi (invece di nuovi e aggiornati!).
Livello in tempo reale / di velocità
L’elaborazione a flusso, cioè il livello in tempo reale o di velocità, in un’architettura lambda serve a dare risposte velocissime alle esigenze di dati in tempo reale. Mantiene viste e metriche basate sull’elaborazione in tempo reale degli eventi.
Livello di precalcolo
L’elaborazione a lotti, cioè il livello di precalcolo, fornisce una base completa e accurata di tutti i dati nel sistema. Elaborare grandi quantità di dati può richiedere tempo, quindi l’elaborazione a lotti non è abbastanza veloce per fare tutto all’istante. Per questo in un’architettura lambda i due livelli lavorano in tandem.
Implementazione
I server backend che gestiscono gli ordini di cibo dall’app lavorano con un flusso di dati di eventi con marca temporale. In sostanza: ogni ordine è un evento nel sistema. Ogni ordine viene salvato con data/ora dell’ordine, data/ora di evasione (consegna o ritiro programmati), dati del cliente e contenuto dell’ordine (numero di piatti e così via).
Riservare e liberare capacità
Se il pagamento fallisce o un ordine viene abbandonato, nel flusso di dati viene aggiunto un ordine "negativo". Con le sue metriche negative neutralizza ogni effetto sui vincoli di capacità. Per esempio: per annullare un ordine di tre pizze, nel flusso di dati si crea un ordine negativo di "meno tre pizze" con la stessa marca temporale di evasione. È un modo elegante per essere certi che la capacità venga sia riservata sia liberata.
Metriche multidimensionali in tempo reale
Invece di ridurre la capacità a contatori, il server backend usa i dati reali del flusso per rispondere alle query sulle metriche in tempo reale. Questo permette al sistema di gestire le differenze di granularità dell’intervallo di tempo.
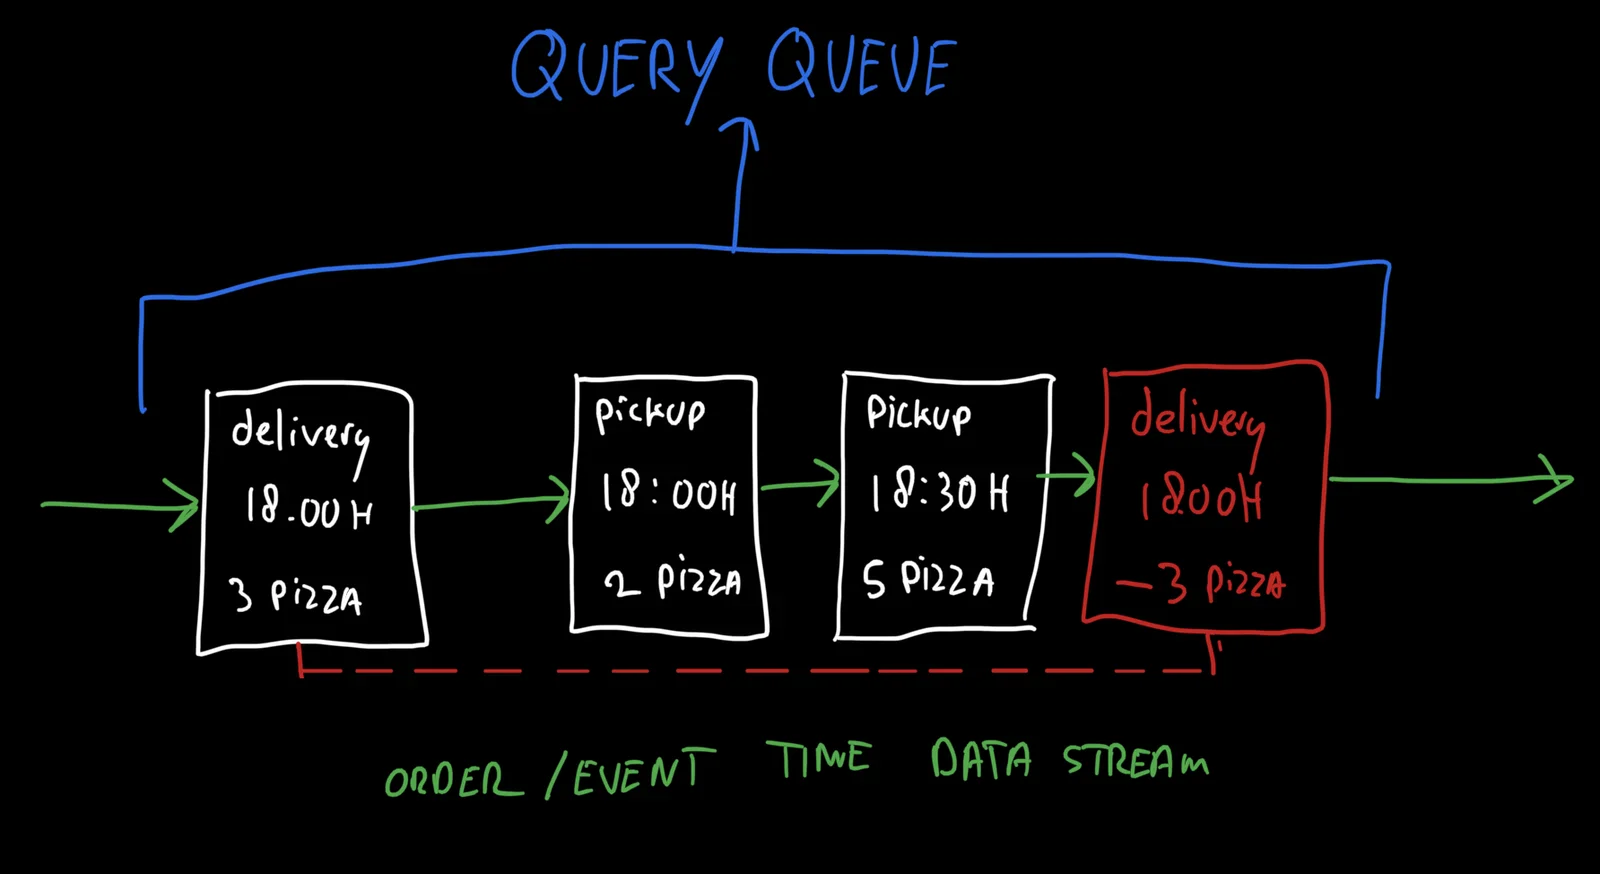
La prima volta che arriva una query per una certa metrica, il sistema carica i dati storici con un meccanismo a lotti per inizializzare il modello, che poi può tenere aggiornato in tempo reale. La metrica resta aggiornata guardando tutti i nuovi ordini che entrano nel sistema finché continuano ad arrivare query per quella metrica. Quando i dati non vengono più richiesti, il modello viene scaricato. Se serve di nuovo, il processo si ripete.
Il bello di questo approccio è che la maggior parte delle query riceve risposta in pochi millisecondi, perché vengono lette direttamente dalla memoria RAM, senza interazioni con database o disco. Questo permette prestazioni altissime in base al "bisogno effettivo". Funziona bene con l’app per ordinare cibo, perché non tutti gli intervalli di tempo sono ugualmente popolari.
L’app interroga ripetutamente un server di capacità centrale che mantiene le metriche della coda. Poi filtra le fasce orarie disponibili guardando le cose che la persona sta effettivamente selezionando per il suo ordine. La scelta di una fascia oraria (probabilmente) disponibile avviene quindi lato client, riducendo il carico sul backend. Quando l’ordine viene effettuato, il backend riserva la capacità aggiornando le metriche centrali della coda, impedendo ad altri di prendere lo stesso posto in coda.
Conclusione
I meccanismi di coda possono essere difficili quando hai a che fare con più metriche che controllano la velocità. Vale la pena prendersi il tempo di modellarlo bene, pensando al tipo di dati che ti servono davvero per eseguire i controlli legati alla coda.
Ora sai che ordinare tre pizze non è così semplice! Garantire che arrivino calde e puntuali è una grande sfida tecnica, oltre a saper fare il cuoco. Per fortuna tua, io non mi occupo di quello, ahah!