
Escrita · 2 dez 2020
Desenhar uma fila de capacidade multidimensional
Gerir a capacidade de cozinha, entregas e recolhas
Este mês precisei de acrescentar dimensões a um mecanismo de fila de capacidade. A app de pedidos de comida que criei tinha de conseguir limitar a capacidade com base no número de pedidos, no conteúdo de cada pedido e no tipo de expedição (take-away/entrega). Lê até ao fim para saberes como usei uma Arquitetura Lambda para o fazer.
Limitar a capacidade
Embora talvez não te tenhas apercebido, uma das funcionalidades mais poderosas da app de pedidos de comida que criei é, na verdade, poder limitar o número de pedidos. Parece contraintuitivo, mas ao limitar o número de pedidos que podem ser feitos, os meus clientes (os donos de restaurantes e de lojas que usam a app) garantem que os pedidos são preparados e entregues como deve ser.
A complexidade das três pizzas
Imagina que queres encomendar três pizzas. A app de comida precisa então de saber:
- Queres ir buscá-las ou que sejam entregues?
- A que horas? Quando é que têm de ir ao forno?
- Há espaço suficiente para três pizzas no forno a essa hora?
- Se escolheste recolha: conseguimos receber-te em segurança a essa hora?
- Se escolheste entrega: há um estafeta disponível para te levar as pizzas?
- Sim a tudo isto? Então paga, por favor, enquanto mantemos as tuas pizzas reservadas no forno e na entrega ou recolha. Não pagaste? Mudaste de ideias? Então «desfazemos» toda a reserva e esperamos que outra pessoa encomende pizzas!
Três dimensões de capacidade
Especialmente à «hora do jantar» há o risco de demasiadas pessoas pedirem comida ao mesmo tempo. Embora a app consiga lidar com o tráfego extra graças à sua arquitetura altamente escalável, as restrições físicas mantêm-se, como:
- capacidade da cozinha: o número de pratos que consegues preparar de uma vez
- capacidade de recolha: o número de pessoas que consegues receber em segurança de uma vez, face às restrições da COVID-19
- capacidade de entrega: o número de pedidos que consegues entregar, tendo em conta o trânsito, a distância e o percurso
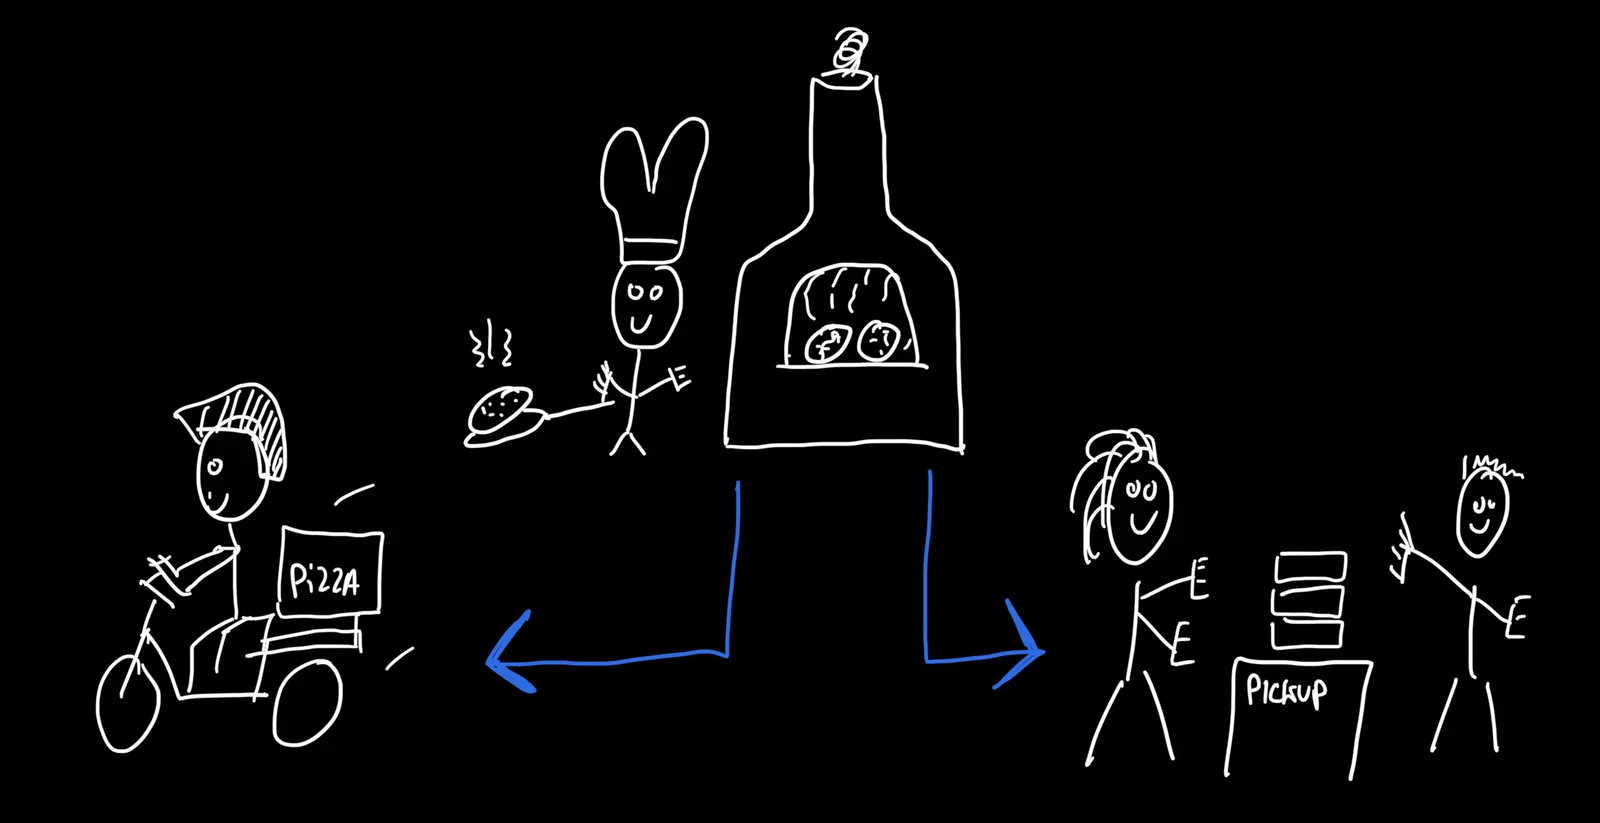
Distintas mas interdependentes
Estes três tipos de restrições são interdependentes. Por exemplo, é possível que um grande pedido para recolha ocupe toda a capacidade da cozinha, o que também deixa a entrega indisponível. Ainda se poderiam aceitar pedidos mais pequenos para preencher a capacidade da cozinha, quando já pode não haver capacidade para pedidos grandes. Isto significa que precisas de um mecanismo que olhe para todas as métricas em conjunto para determinar a disponibilidade para novos pedidos, incluindo o conteúdo de um pedido ainda não feito (por exemplo, o que está no teu carrinho de compras).
Diferenças na granularidade dos intervalos de tempo
É comum definir uma restrição física com um intervalo de tempo, por exemplo «a cozinha consegue produzir 10 pratos em cada 15 minutos». Torna-se difícil quando defines outras restrições físicas com intervalos de duração diferente. Enquanto a cozinha pode ser limitada a cada 15 minutos, a capacidade de entrega pode usar um intervalo maior (por exemplo, 3 entregas em cada 30 minutos). De algum modo, o mecanismo tem de saber lidar com estas diferenças de granularidade.
Encomendar com antecedência
O desafio aumenta com a opção de as pessoas fazerem os pedidos com antecedência. As pessoas podem escolher um horário no futuro e ter a capacidade necessária reservada. Às vezes vejo pessoas fazerem o pedido com dias de antecedência para terem a certeza de que a comida é entregue num dia e hora específicos. Isto significa que há (pelo menos) dois momentos associados a cada pedido: a hora do pedido e a hora da entrega.
Reservar e libertar capacidade
A maioria dos donos de negócios exige pagamentos online para os pedidos online, para garantir que todos os pedidos são genuínos e que não se desperdiça capacidade (nem comida) com faltas ou pedidos fantasma. O problema dos pagamentos online é que nem todas as transações têm sucesso. Às vezes um pagamento com cartão de crédito ou débito é rejeitado (por exemplo, por falta de saldo). Outras vezes as pessoas fecham simplesmente a app antes de concluir o pedido. O sistema deve reservar a capacidade necessária para um dado pedido enquanto permite que a pessoa faça o pagamento online, e deve libertar a capacidade reservada se o pedido for abandonado ou se o pagamento falhar.
Muito volume, muita velocidade
Por último, mas não menos importante, o mecanismo tem de ser fiável e rápido. A disponibilidade de pedidos deve ser determinada em meros milissegundos, com muita concorrência, porque há muitos clientes diferentes ligados à app de pedidos de comida nas horas de ponta. Quando alguém faz um pedido, isso afeta a disponibilidade de todos os outros pedidos (potenciais). Nem todos estão ligados de forma fiável, porque algumas pessoas usam a app em telefones com má receção ou em wifi fraco. O sistema tem de funcionar bem em condições variáveis, com muitas pessoas ligadas.
Arquitetura Lambda
A Arquitetura Lambda é uma forma de lidar com grandes quantidades de dados, usando em simultâneo métodos de processamento em fluxo e em lote. Uma arquitetura lambda depende de um modelo de dados com uma fonte de dados só de acrescento e imutável, muitas vezes composta por eventos com marca temporal.
Dados imutáveis
Esta é uma base muito importante do mecanismo: todos os dados têm marca temporal e nunca mudam. Em vez de alterar registos existentes, simplesmente acrescentam-se novos registos que sobrepõem os existentes. Isto permite muita concorrência e algoritmos distribuídos, porque a sincronização fica mais simples: basta procurar dados novos (em vez de novos e atualizados!).
Camada em tempo real / de velocidade
O processamento em fluxo, ou camada em tempo real / de velocidade, numa arquitetura lambda foi pensado para dar respostas super rápidas às necessidades de dados em tempo real. Mantém vistas e métricas baseadas no processamento de eventos em tempo real.
Camada de pré-computação
O processamento em lote, ou camada de pré-computação, fornece uma base completa e exata de todos os dados do sistema. Como processar grandes quantidades de dados pode demorar, o processamento em lote não é suficientemente rápido para fazer tudo instantaneamente. É por isso que as duas camadas trabalham em conjunto numa arquitetura lambda.
Implementação
Os servidores de backend que tratam os pedidos de comida da app trabalham com um fluxo de dados de eventos com marca temporal. No essencial: cada pedido é um evento no sistema. Cada pedido é guardado com a sua data/hora de pedido, data/hora de expedição (hora agendada de entrega ou recolha), dados do cliente e conteúdo do pedido (número de pratos, etc).
Reservar e libertar capacidade
Se o pagamento falha ou se um pedido é abandonado, é acrescentado ao fluxo de dados um pedido «negativo». Neutraliza qualquer efeito nas restrições de capacidade com as suas métricas negativas. Por exemplo: para cancelar um pedido de três pizzas, cria-se no fluxo de dados um pedido negativo de «menos três pizzas» com a mesma marca temporal de expedição. É uma forma elegante de garantir que a capacidade é reservada e libertada.
Métricas multidimensionais em tempo real
Em vez de abstrair a capacidade em contadores, o servidor de backend usa os dados reais do fluxo para responder a consultas de métricas em tempo real. Isto permite ao sistema lidar com as diferenças de granularidade dos intervalos de tempo.
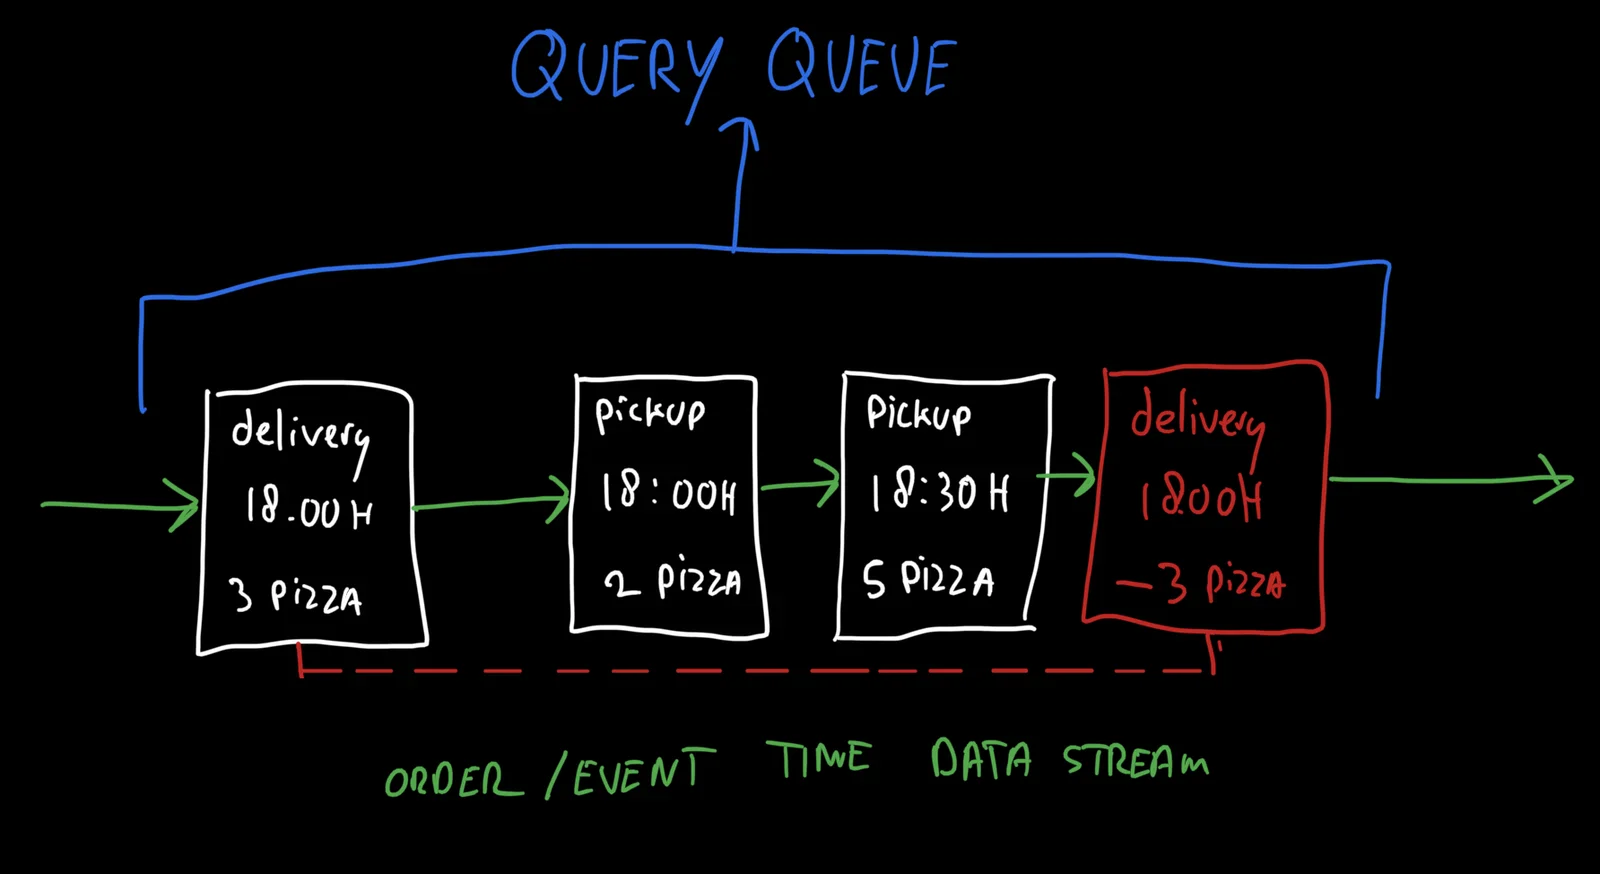
Quando recebe pela primeira vez uma consulta para uma dada métrica, o sistema carrega dados históricos através de um mecanismo em lote para inicializar o modelo, que depois consegue manter atualizado em tempo real. Esta métrica é mantida atualizada olhando para todos os novos pedidos que entram no sistema enquanto chegarem consultas para essa métrica. Quando os dados deixam de ser pedidos, o modelo é descartado. Se for preciso outra vez, o processo repete-se.
O melhor desta abordagem é que a maioria das consultas é respondida em meros milissegundos, porque são lidas diretamente da memória RAM, sem interação com base de dados nem disco. Isto dá um desempenho ultra elevado «conforme a necessidade». Funciona bem com a app de pedidos de comida porque nem todos os intervalos de tempo são igualmente populares.
A app de pedidos de comida consulta repetidamente um servidor central de capacidade que mantém as métricas da fila. Depois filtra os horários disponíveis olhando para o que a pessoa está realmente a escolher para o seu pedido. Escolher um horário (provavelmente) disponível acontece, assim, do lado do cliente, o que reduz a carga no backend. Quando um pedido é feito, o backend reserva a capacidade atualizando as métricas centrais da fila e impedindo que outras pessoas reclamem o mesmo lugar na fila.
Conclusão
Os mecanismos de fila podem ser difíceis quando lidas com várias métricas que controlam a velocidade. Vale mesmo a pena dedicar tempo a modelar bem, pensando no tipo de dados de que realmente precisas para fazer verificações relacionadas com a fila.
Agora sabes que encomendar três pizzas não é assim tão simples! Garantir que podem ser servidas quentes e a horas é um grande desafio técnico, além de ser bom cozinheiro. Ainda bem que eu não me concentro nisso, ha!